Le Hub · Passerelle IA
Une porte vers les modèles,
des yeux sur le web.
Les clés des fournisseurs d’IA restent au même endroit, la consommation se compte par application, et les agents partagent les mêmes navigateurs pour lire les pages.
À quoi ça sert
Un programme qui appelle un modèle de langage a besoin d’une clé chez un fournisseur, d’un plafond de dépense, et de savoir combien il consomme. Multipliez par dix programmes et trois fournisseurs : les clés se dispersent, et la facture arrive en fin de mois.
Le Hub propose une passerelle : une seule porte vers plusieurs fournisseurs de modèles. Les programmes et les organisations y ont leurs quotas, leurs tarifs, leurs sessions, et un relevé de consommation.
Un agent IA doit aussi lire le web. Une page moderne ne livre souvent son texte qu’après exécution de son JavaScript. Le Hub fait tourner, une fois pour tous, les navigateurs sans écran qui s’en chargent.
Ce qu’on voit à l’écran
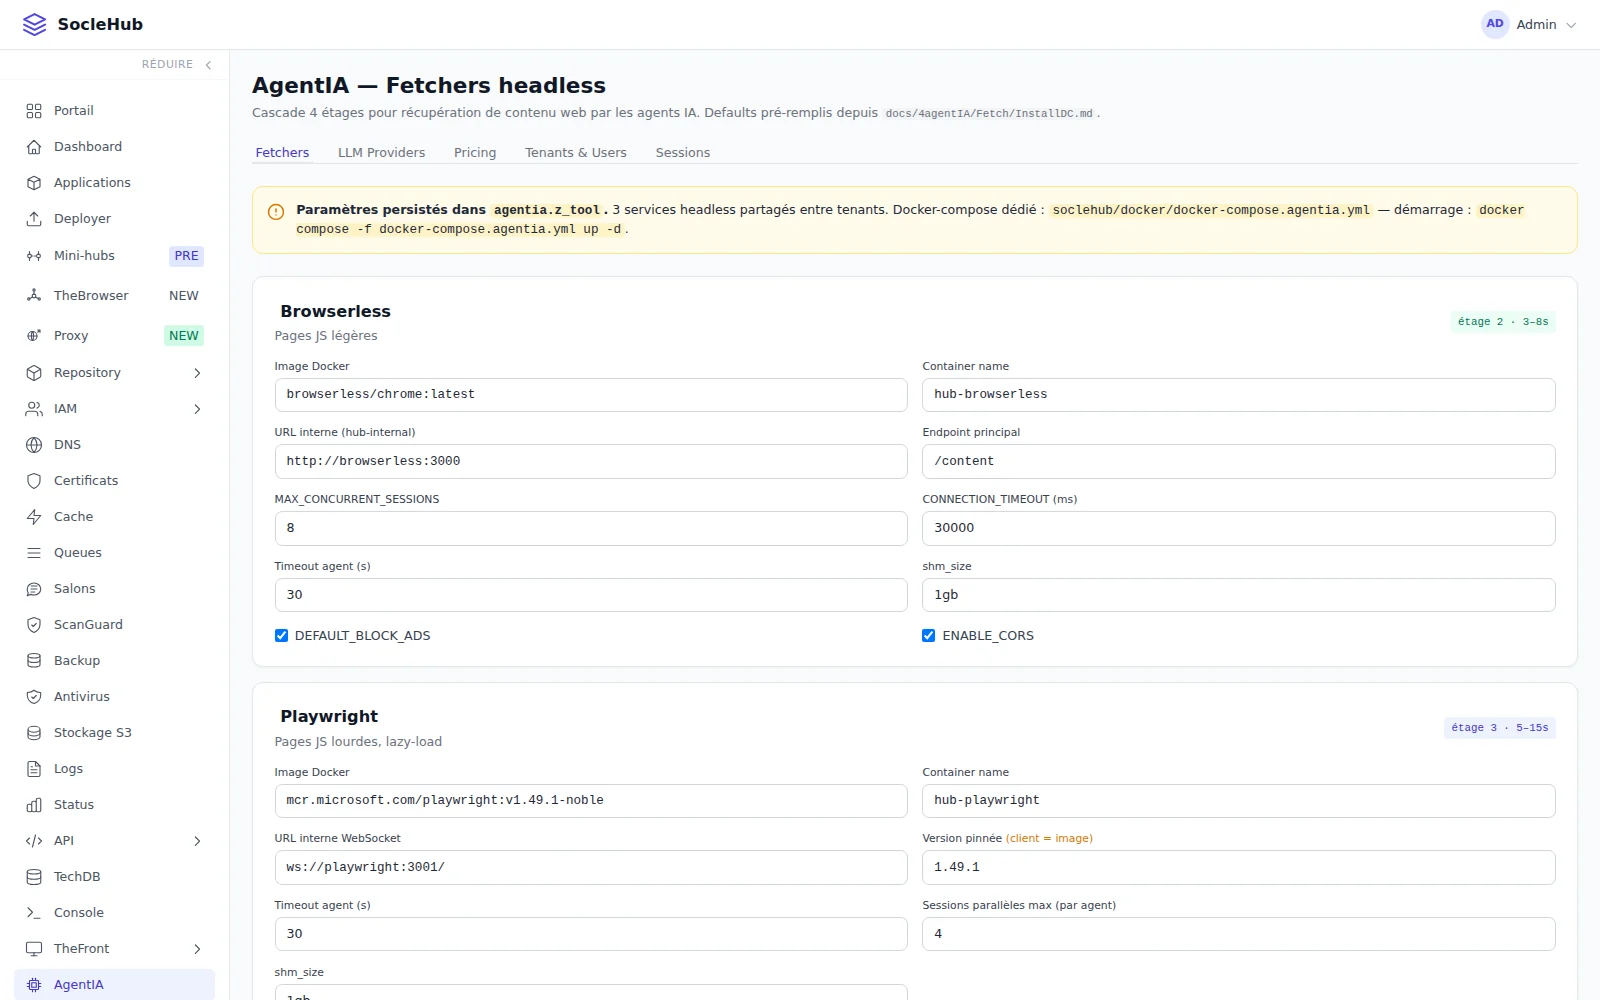
L’écran est celui du Hub thesocle.net, au 2026-09-23. Il montre l’onglet des outils de récupération du web ; les autres onglets portent les fournisseurs de modèles, les tarifs, les organisations et utilisateurs, et les sessions.
Le titre annonce une cascade à quatre étages. L’agent demande une page ; on essaie d’abord le moyen le plus simple et le plus rapide, et on ne monte d’un étage que si le texte obtenu est inexploitable.
Le bandeau jaune précise que ces réglages sont enregistrés dans la base du Hub, et que trois services de navigation sont partagés entre toutes les organisations.
Browserless, étage 2, pour les pages en JavaScript léger : compter 3 à 8 secondes. On lit ses réglages : 8 sessions simultanées au plus, 30 secondes de délai de connexion et 30 secondes accordées à l’agent, blocage des publicités activé.
Playwright, étage 3, pour les pages lourdes, qui se chargent en défilant : 5 à 15 secondes. Sa version est épinglée (1.49.1), pour que le client et le navigateur restent d’accord, avec 4 sessions parallèles au plus par agent.
Comment on s’en sert
On déclare les fournisseurs
Les modèles accessibles et leurs clés, rangées dans le Hub. Sur ce Hub, sept fournisseurs sont déclarés.
On inscrit l’application
Elle reçoit son accès à la passerelle, rattaché à une organisation.
On fixe les plafonds
Quotas et tarifs par organisation ; la consommation se lit dans le relevé.
L’agent lit le web
Il demande une page ; la cascade choisit l’étage. Il n’embarque aucun navigateur.
Ce que ça vous évite
Des clés de fournisseurs d’IA dans chaque programme
Elles restent au même endroit, dans votre Hub.
La facture d’IA découverte en fin de mois
Chaque application, chaque organisation a son plafond et son relevé.
Un navigateur à embarquer dans chaque agent
Les navigateurs sont partagés, réglés une fois.
Les limites d’aujourd’hui
La passerelle mesure et plafonne ; elle n’accélère pas un modèle. Le débit et les délais de réponse dépendent du fournisseur choisi.
Lire une page n’est pas instantané : de quelques dixièmes de seconde pour une page simple à une quinzaine de secondes pour une page lourde.